Wie baut man einen physischen KI-Assistenten, der gesprochene Sprache versteht und über einen Lautsprecher antwortet?
Ein Praxisbeispiel aus unserem Lab.
Was der Prototyp kann
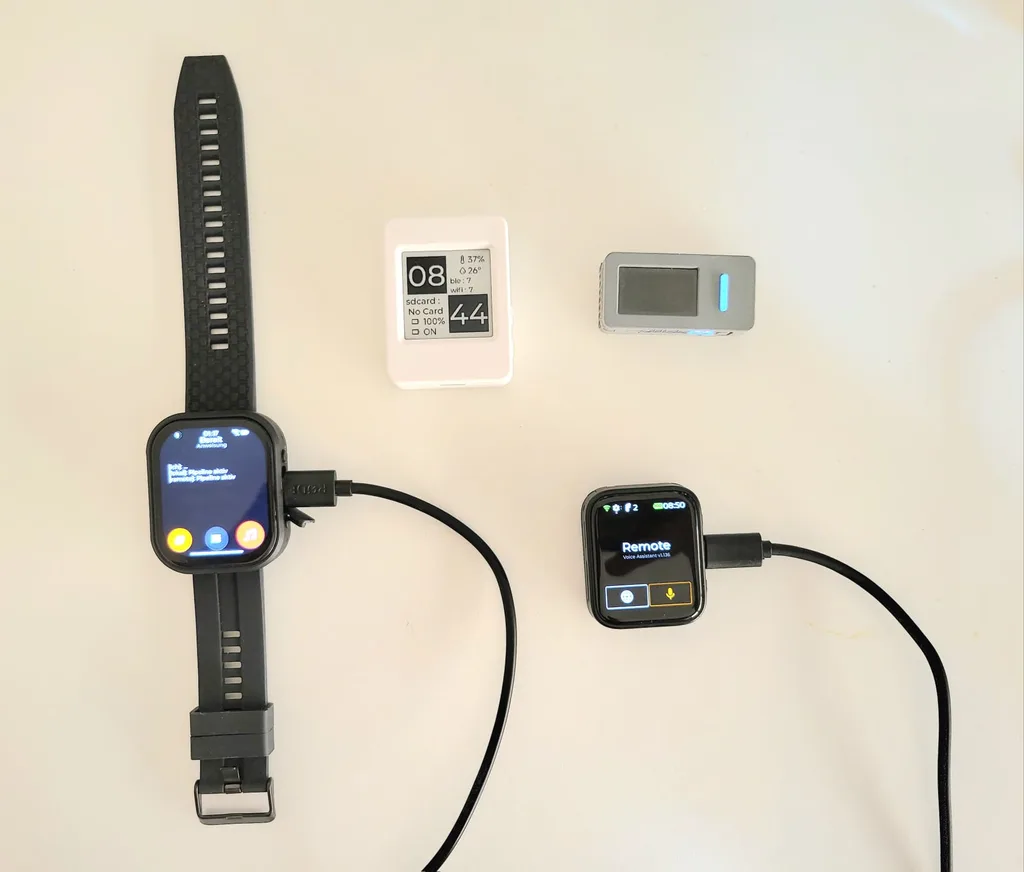
Man tippt auf den Aufnahme-Button, spricht eine Frage, und nach einigen Sekunden kommt die gesprochene Antwort. Zusätzlich erscheint der Text auf dem Display. Inzwischen geht es auch ohne Taste: das Gerät hört von selbst zu und antwortet in Gesprächslücken.
- Sprache rein, Sprache raus: Aufnahme über das eingebaute Mikrofon, Wiedergabe über den Lautsprecher.
- Drei Betriebsarten: eine lokale Kette (Erkennung und Sprachausgabe laufen auf dem eigenen Server), eine Remote-Kette mit schnelleren Cloud-Modellen — und ein freihändiger Dialogmodus.
- Freihändiger Dialog („Buddy-Modus“): statt für jeden Satz die Taste zu drücken, läuft das Gerät einfach mit. Es hört dauerhaft zu, erkennt selbst, wann ein Satz zu Ende ist (nach etwa drei Sekunden Ruhe) und antwortet — aber nur auf echte Fragen. Auf eine Feststellung wie „Das Wetter ist heute mies.“ schweigt es; auf „Wie wird das Wetter morgen?“ antwortet es. Solange es selbst spricht, hört es nicht zu — wie bei einem Funkgerät. Im Auslieferungszustand ist der Modus aus.
- Streaming statt Blockabfertigung, der eigentliche Durchbruch: die Antwort wird nicht mehr vollständig abgewartet, sondern satzweise freigegeben, sobald ein Satz fertig ist. Der erste Satz ist nach etwa 1,7 Sekunden hörbar. Vorher lief die Kette am Stück ab: Bei längeren Antworten summierte sich das im ungünstigen Fall auf bis zu 25 Minuten, bis überhaupt eine erste Ausgabe kam — die Vertonung und das Nachladen des fertigen Audios mussten komplett durchlaufen, bevor ein Ton zu hören war.
- Touch-Menü: WLAN-Auswahl mit Bildschirmtastatur, Display-Helligkeit und -Timeout, Audiopegel, Zeitzone, Stoppuhr, Wecker.
- Recherche-Modus: auf Wunsch eine ausführliche Antwort mit Quellen statt eines knappen Satzes.
- OTA-Update: neue Firmware lädt das Gerät per W-LAN aus dem Netz, mit zwei getrennten Programmspeichern, sodass ein Rücksprung möglich bleibt.
- Nebenbei: Schrittzähler, Batterieanzeige, Protokollierung jeder Frage und Antwort auf einer internen Speicherkarte.
Wie es funktioniert
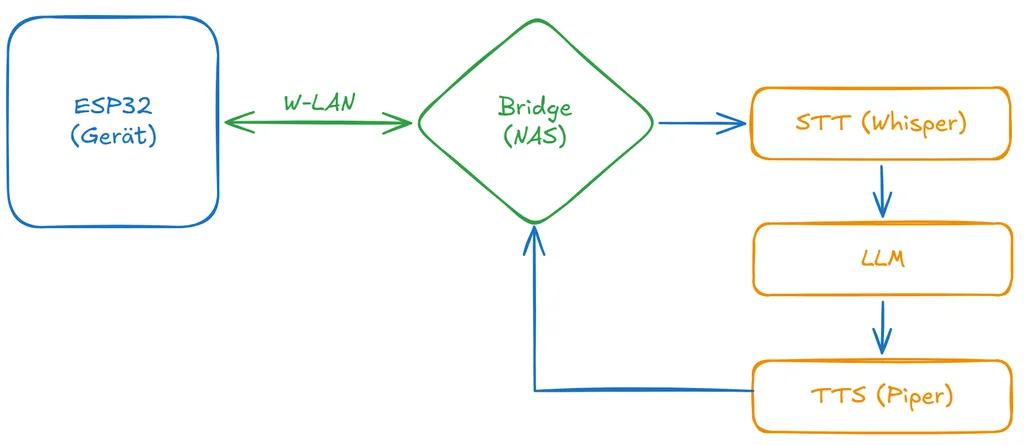
| # | Schritt | Wo | Was passiert |
|---|---|---|---|
| 1 | Aufnahme | Gerät | 16 kHz mono, maximal 25 Sekunden |
| 2 | Übertragung | Gerät → Server | Audiodatei verschlüsselt an eine Bridge, mit Zugangsschlüssel |
| 3 | Verstehen | Server | Spracherkennung: aus Sprache wird Text |
| 4 | Antworten | Server | Ein Sprachmodell formuliert die Antwort, eine Sprachausgabe vertont sie |
| 5 | Abholen | Gerät | Status abfragen, Audio in Teilen laden, abspielen |
Die Idee dahinter: das Gerät bleibt dumm
Die gesamte Intelligenz liegt auf einem (lokalen) Server. Das Gerät nimmt auf, fragt nach und spielt ab. Der Vorteil: Spracherkennung, Sprachmodell und Stimme lassen sich austauschen, ohne die Firmware des Geräts anzufassen. Eine Verbesserung auf dem Server wirkt sofort auf allen Geräten.
Die Hardware
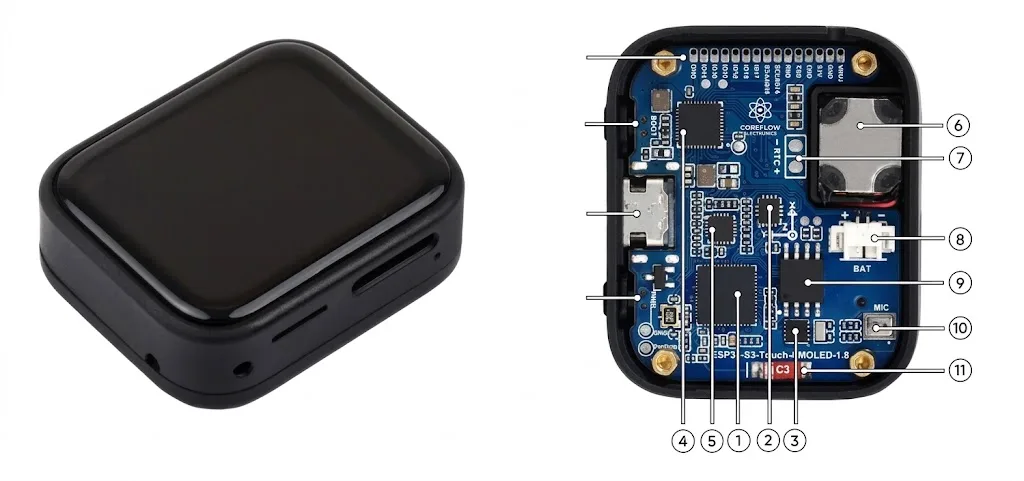
- ESP32-S3 — Dual-Core, 16 MB Programmspeicher, 8 MB Arbeitsspeicher1https://docs.waveshare.com/ESP32-S3-Touch-AMOLED-1.8
- AMOLED-Display 368 × 448 mit kapazitivem Touch
- Audio-Codec für Mikrofon und Lautsprecher (I2S-Anbindung)
- Powermanager für Akku, Ladung und Spannungsversorgung
- Lagesensor für den Schrittzähler
- microSD für Dateien und Protokolle
- WLAN und Bluetooth für die Kommunikation
Die Server-Seite
Auf einem lokalen Server läuft eine kleine Schnittstelle („Bridge“) in einem Docker Container, die die gesamte Kette bedient. Sie ist mit vier Endpunkten bewusst schmal gehalten:
POST /v1/voice              Audio hochladen  →  Aufgaben-Nummer
GET  /v1/voice/status/<id>  Fortschritt abfragen
GET  /v1/voice/result/<id>  Antwort-Audio laden
GET  /ota/v1/manifest       Firmware-Version bereitstellen
Jede Stufe ist austauschbar: Spracherkennung, Sprachmodell, Sprachausgabe können lokal oder über eine Cloud gestreamt werden.
Gemessene Zahlen (am echten Protoypen)
| Stufe | Dauer |
|---|---|
| Spracherkennung | 0,8 – 2,9 s |
| Sprachmodell (Antwort formulieren) | 1,1 – 4,3 s |
| Sprachausgabe (Vertonung) | 1,2 – 5,4 s |
| Summe auf dem Server | 5 – 9 s |
Diese Summe beschreibt, wie lange die vollständige Antwort auf dem Server entsteht. Für den ersten hörbaren Ton zählt sie seit der Streaming-Umstellung nicht mehr — dazu unten mehr. Entscheidend ist ohnehin nicht der Code, sondern der Weg zum Server:
| Situation | erster Satz hörbar | vollständige Antwort |
|---|---|---|
| im eigenen WLAN | etwa 1,7 Sekunden | etwa 6 – 9 Sekunden |
| unterwegs über Mobilfunk (Tailscale Tunnel) | länger als im WLAN | spürbar länger |
Vor der Umstellung auf satzweise Auslieferung wartete man immer auf die komplette Antwort: etwa zehn Sekunden im WLAN, zwanzig über Mobilfunk. Heute beginnt die Antwort, sobald der erste Satz fertig ist.
Der Grund für den Unterschied zwischen den beiden Wegen ist unspektakulär und lehrreich: Eine einzelne Abfrage kostet im WLAN rund zwei Millisekunden, über die Funkstrecke etwa 300 Millisekunden. Bei vierzig Abfragen sind das zwölf Sekunden Unterschied — der Weg zum Server, nicht die Rechenleistung, bestimmt das Tempo. Über Mobilfunk bleibt der Funkweg darum der Bremsklotz, auch wenn der erste Satz dort früh kommt.
Der schnellste Hebel war nicht die Rechenzeit
Unsere erste Messung legte nahe, die Antwortzeit sei eine Frage des Sprachmodells. Wir hatten die Serverkette in drei Stufen zerlegt — Spracherkennung, Modell, Vertonung — und jede Stufe für sich gemessen: 0,8–2,9 s, 1,1–4,3 s, 1,2–5,4 s. Zusammen fünf bis neun Sekunden. Der naheliegende Schluss war: ein schnelleres Modell muss her.
Er war falsch. Der eigentliche Gewinn lag in der Reihenfolge, in der wir die Arbeit erledigen. Vorher wartete die Kette blockierend, bis das Modell seinen kompletten Text fertiggeschrieben hatte — erst danach wurde in Sätze geteilt und vertont. Der erste Ton konnte also frühestens nach der ganzen Modellzeit kommen. Jetzt liest die Bridge den Wortstrom des Modells, sobald er eintrifft, und gibt jeden Satz frei, sobald er vollständig ist. Die Vertonung beginnt, während das Modell noch weiterschreibt.
| Was man hört | vorher (Block) | nachher (Stream) |
|---|---|---|
| Der erste Ton | 2,9 – 4,5 s — und zwar erst, wenn die ganze Antwort fertig war | 1,68 s — der erste Satz, während der Rest noch entsteht |
| Nach zwei Sekunden | nichts (die Kette rechnet und lädt) – die Ladezeit konnte bis zu 25 Sekunden betragen. | bereits zwei Sätze (der zweite bei 1,99 s) |
Derselbe Rechner, dasselbe Modell, dieselbe Stimme. Der Vergleich hinkt nicht: Auch vorher war der erste Satz irgendwann fertig — nur eben erst nach der kompletten Antwort und dem kompletten Nachladen. Jetzt liegt der erste Satz nach 1,7 Sekunden vor, der zweite nach zwei. Aus „einmal am Ende“ wurde „laufend, sobald fertig“ — allein durch eine Änderung am Ablauf.
Die Lehre: Bei einer Sprachkette zählt nicht die Gesamtdauer der Berechnung, sondern wann das erste Stück fertig ist. Wer auf das Ganze wartet, zahlt die volle Summe; wer in Sätzen ausliefert, zahlt nur den ersten Satz. Diese Umstellung hat mehr gebracht als jede Modell- oder Hardware-Diskussion.
Der Entwicklungs-Stack
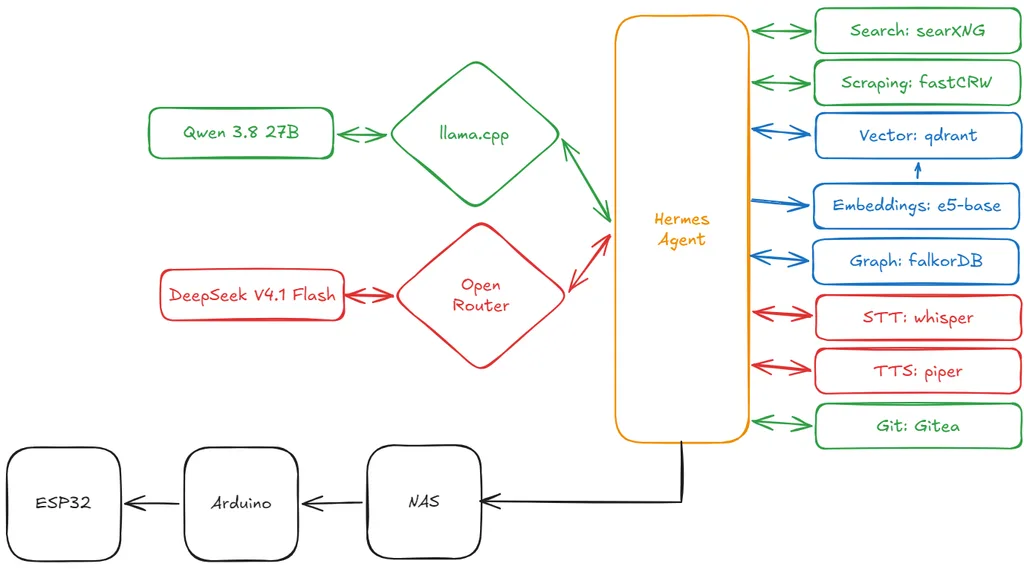
Für die Entwicklung wurde ein lokaler KI-Agent2https://hermes-agent.nousresearch.com genutzt. Zum Einsatz kam ein lokales Sprachmodell (Qwen3https://qwen.ai/ 3.8 27B über llama.cpp4https://github.com/ggml-org/llama.cpp) und ein Cloud-Modell (DeepSeek5https://api-docs.deepseek.com/ V4.1 Flash via Open Router6https://openrouter.ai/). Der Agent greift auf ein Arsenal an Werkzeugen und Skills zu, darunter Module für die Websuche (searXNG7https://docs.searxng.org/) und Scraping (fastCRW8https://www.firecrawl.dev/), Wissensspeicher wie Vektor- und Graphdatenbanken (qdrant9https://qdrant.tech/, falkorDB10https://www.falkordb.com/) sowie Sprachein- und -ausgabe über Whisper11https://github.com/openai/whisper (STT) und Piper12https://github.com/rhasspy/piper (TTS). Die physische Umsetzung oder Auslieferung erfolgt über eine Release-Pipeline, die von einem NAS über einen Arduino bis zum Mikrocontroller verläuft. Eine voll-automatisierte Release-Pipeline (inkl. Compiler) bis zum Gerät ist möglich (und wurde auch schon realisiert).
Die genutzten Software-Komponenten (bis auf die Arduino IDE13https://www.arduino.cc/en/software und OpenRouter) sind Open Source und somit frei verfügbar.
Was noch offen ist
- Die Download-Grenze: Ursache gefunden und behoben. Im letzten Beitrag hieß es noch, der Grund sei unklar. Er ist es nicht mehr: Das Gerät brach beim Lesen des Antwort-Bodys reproduzierbar bei rund 3,6 Kilobyte ab. Der Grund lag nicht am Gerät, sondern am Server — er schickte den kompletten Body in einem einzigen großen TLS-Stück, das der kleine Empfänger nicht am Stück lesen konnte. Die Bridge liefert den Body jetzt in 2-Kilobyte-Stücken aus; der Empfänger liest sie einzeln. Damit ist die Grenze weg — eine Änderung an einer Zeile Serverkonfiguration statt an der Firmware.
- Antwortlänge bleibt ein Kostenfaktor: Jedes Stück Antwort-Audio muss einzeln abgeholt werden, und das kostet Zeit. Als Regel gilt: das Abholen kostet ungefähr 2,7 Sekunden pro Sekunde Sprache. Damit ein einzelner Satz nicht zu groß wird, begrenzt die Bridge den Satzschnitt auf 70 Zeichen. Kürzere Antworten sind also nicht nur schneller formuliert, sie sind auch schneller beim Gerät.
- Tempo über die Funkstrecke: der verbleibende Bremsklotz. Die Ursache ist gemessen (viele kleine Abfragen, jede mit Wartezeit — im WLAN rund zwei Millisekunden, über die Funkstrecke etwa 300). Dieser Posten wird weiter angegriffen: größere Stücke pro Abfrage, damit weniger Umläufe nötig sind.
- Akku und Erwärmung im Dauerbetrieb: der freihändige Modus läuft dauerhaft mit — das kostet Strom und erzeugt Wärme. Eine belastbare Messung dazu steht noch aus; bis dahin nennen wir bewusst keine Zahl.
- Server-Test ist kein Gerätetest: Ein Ansatz, der auf dem Server funktioniert, muss auf dem Gerät im Realbetrieb noch lange nicht funktionieren.
- Klangqualität: Die Sprachausgabe kann telefonähnlich klingen, wenn sie komprimiert wird, um Bandbreite zu sparen.
Fazit und Ausblick
Ein Sprachassistent auf einem Mikrocontroller ist heute kein Forschungsthema mehr, die Bausteine sind alle da. Die eigentliche Arbeit steckt in den Details: wie das Gerät mit schwankenden Netzen umgeht, wie lange eine Antwort dauern darf, und wie man Fehler findet, die nur auf echter Hardware auftreten.
Frei programmierbare Mikrocontroller bieten wunderbare Möglichkeiten im Zusammenspiel mit KI. Wir nutzen diese Geräte, um die Möglichkeiten von KI im niedrigschwelligen Einsatz zu demonstrieren.
In unseren AI-Workshops vermitteln wir Unternehmen den praktischen Nutzen und die konkrete Anwendung von KI.
Präsentation
Quellen:
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
- 11
- 12
- 13