
AI WARS: Wie wir ein Strategiespiel mit einem KI-Agenten gebaut und mit 10.000 Partien vermessen haben
KI · KI Agenten · KI-Labor
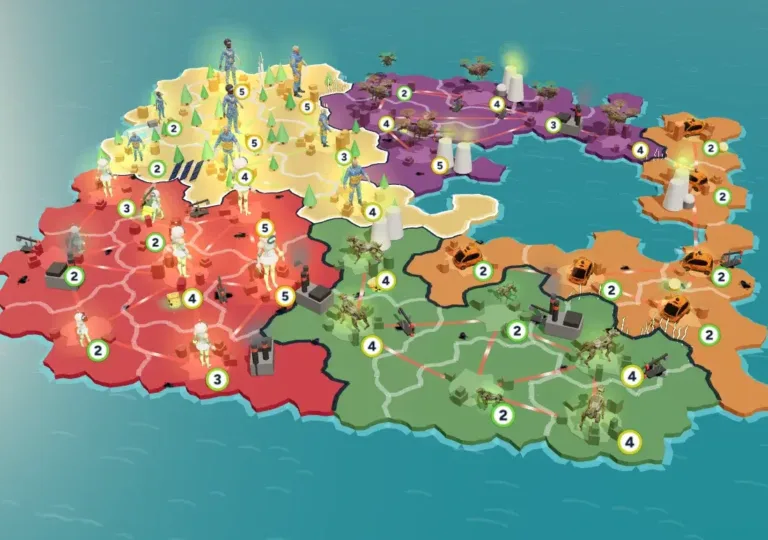
Vier Tage, 147 Commits, ein Mensch, der die Regeln vorgibt, und ein KI-Agent, der baut: Unser Browserspiel AI WARS ist auch ein Experiment. Wir wollten wissen, ob sich Spielspaß und Fairness messen lassen, statt sie zu erraten. Die Simulation hat uns mehrfach widersprochen.
1. Fragestellung
AI WARS ist ein Brettspiel im Browser: Die Menschen erobern die Welt Feld für Feld von bis zu vier KIs zurück (Regeln und Fraktionen stehen auf der Projektseite). Hinter dem Spiel stehen zwei Fragen:
- Arbeitsteilung: Kann ein Mensch, der nur Regeln, Gestaltung und Entscheidungen vorgibt, zusammen mit einem KI-Agenten in wenigen Tagen ein spielbares, faires Strategiespiel bauen?
- Messbarkeit: Lässt sich Balance messen, bevor echte Menschen spielen? Und zwar so, dass die Messung Entscheidungen verändert und nicht nur bestätigt?
Unsere Hypothese am Anfang: Wenn die Regeln klar sind, reicht Bauchgefühl beim Testspielen, um die Balance einzustellen. Die Simulation sollte das nur absichern.
2. Versuchsaufbau
Rollen. Der Mensch gibt Spielidee, Regeln und Gestaltung vor, spielt, prüft und entscheidet. Der KI-Agent schreibt Spiellogik, Gegner, 2D- und 3D-Ansicht und schlägt Änderungen vor. Jede Regeländerung wird erst als Vorschlag gezeigt und dann vom Menschen entschieden.
Feste Vorgaben des Menschen (sie galten als Randbedingungen jedes Versuchs):
- Die KIs bekommen keine Wertvorteile. Stärke ist nur Taktik. Begründung: Die Menschen spielen ohnehin gegen mehrere Fraktionen.
- Ein Kampf soll klar lesbar sein: Ein deutlich stärkerer Angreifer verliert selten, ein deutlich schwächerer gewinnt kaum.
- Die Partie endet erst, wenn alle Gegner vom Netz sind. Ein vorzeitiges Ende macht keinen Spaß.
Variablen. Zahl der KIs (1 bis 4), KI-Stärke (Narrow, General, Super AI), Joker, Ereignisse, Startaufstellung, Zusammenschluss der KIs (Schulterschluss, Letztes Gefecht).
Messinstrument. Ein Simulator lässt den echten Spielkern ohne Oberfläche laufen. Die Seite der Menschen spielt dabei ein Bot mit derselben Logik wie die KIs, meist in der höchsten Stufe. Gemessen werden Siegquote der Menschen, Rundenzahl (Median und 90. Perzentil), Kämpfe, Führungswechsel, Wirkung jedes Jokers und Partien, die nach 200 Runden noch offen sind. Je Einstellung 120 bis 400 Partien, insgesamt über 10.000 Partien. Die Schwankung liegt bei 400 Partien bei etwa ±4,5 Prozentpunkten, bei 120 bei etwa ±9.
Abschaltversuche. Um die Wirkung einzelner Regeln zu sehen, haben wir jeweils genau eine Regel ausgeschaltet und den Rest gleich gelassen.
3. Beobachtungen und Messungen
3.1 Der erste Befund: Die Partie ist nach einem Drittel entschieden
Die erste große Messung am 06.11. (3 KIs, Stufe General, 400 Partien) zeigte:
- Die Führung wechselte zuletzt nach rund einem Drittel der Partie.
- Wer in Runde 5 vorn lag, gewann zu 90 %. Wer deutlich hinten lag, gewann nie.
- Bei Siegen der Menschen waren 62 % der Runden nur noch Abräumen.
Beim Testspielen hatte sich das spannend angefühlt. Die Zahlen sagten: Der Ausgang steht früh fest, danach wird nur noch vollzogen.
3.2 Die KI-Stufen waren kaum spürbar
Bei 3 KIs gewann der Bot gegen Narrow, General und Super zu 73, 68 und 64 %. Der Unterschied zwischen leichtester und schwerster Stufe lag kaum über der Messschwankung.
3.3 Das stärkste Element war unsichtbar
Die Abschaltversuche (400 Partien je Zeile, Basis 70 % Sieg):
| Ausgeschaltet | Sieg Mensch | Lesart |
|---|---|---|
| Schonrunde am Anfang | 30 % | sehr starker Hebel |
| Anzugsrecht der Menschen (KIs beginnen) | 35 % | sehr starker Hebel |
| Energiefalle | 62 % | spürbar |
| Backup | 64 % | spürbar |
| Boost | 69 % | kein Effekt |
| verborgene Fähigkeiten der Fraktionen | 69 % | kein Effekt |
| Zusammenschluss der KIs | 70 % | kein Effekt |
| Blackout | 76 % | Blackout half den KIs |
| alle Joker | 76 % | Joker verlängern die Partie um 45 % |
Zwei Regeln, die niemand beim Spielen bemerkt, wer zuerst zieht und wann angegriffen werden darf, wogen schwerer als alle Joker zusammen. Drei Mechaniken, die uns wichtig waren (verborgene Fähigkeiten, Schulterschluss, Zusammenschluss), änderten die Siegquote messbar nicht.
3.4 Was nicht funktioniert hat
Die naheliegende Bremse für Führende ist ein Einkommensdeckel. Gemessen:
- Deckel bei 12 Punkten je Zug: 28 % Sieg, 51 von 400 Partien nach 200 Runden noch offen.
- Deckel bei 8 Punkten: 2 % Sieg, 160 von 400 Partien offen.
Die Partien endeten schlicht nicht mehr. Auch ein Extra-Joker für die kleinste Fraktion oder Zufallsereignisse (Computervirus, Stromausfall, Aufstand) brachten keine echten Comebacks. Die Ereignisse sind fair, Führende verloren danach nur in 0 bis 2 % der Fälle die Partie. Sie verschoben die Fläche der Menschen aber nur um rund zwei Felder in drei Runden.
3.5 Fair zwischen den Fraktionen
Welche KI zuerst ausscheidet, war gleich verteilt (rund 800 Partien): murX 33 %, Misanthropic 30 %, DizzleAI 28 %, Surrax 27 %. Das liegt innerhalb der Schwankung. Unterschiede im Verhalten waren messbar: DizzleAI griff mit 3,4 Angriffen je Zug am häufigsten und riskantesten an (81 % Erfolg), Misanthropic mit 2,6 am seltensten (89 %).
3.6 Vier Tage Iteration
Aus den Messungen wurden Vorschläge, aus den Vorschlägen Entscheidungen des Menschen. Die Siegquote des Bots bei 3 KIs (Narrow / General / Super) über die Stände:
| Stand | Änderung | Sieg Mensch |
|---|---|---|
| 06.11., Ausgang | ungleiche Stufen | 73 / 68 / 64 % |
| 06.11. | Stufen über Zusammenschluss-Zeitpunkt, Letztes Gefecht ab 80 % | 73 / 59 / 34 % |
| 07.11. | Start mit einem Feld je Fraktion, Zufallsereignisse | 74 / 50 / 35 % |
| 07.11. | keine Schutzzeit, Sieg erst, wenn alle Gegner raus sind | 26 / 21 / 12 % |
| 07.11. | Kampfglück: beide Seiten +0 bis 12 zur Augensumme | 39 / 20 / 11 % |
| 08.11., Version 6.7 | Sabotage, stärkere Firewall | 35 / 18 / 15 % |
| 08.11., Version 8.2 | Siegkosten, neue KI-Stufen | 78 / 59 / 20 % |
| 10.11., Version 8.2.12 (Nachmessung) | Sabotage nur neben eigenem Gebiet | 81 / 51 / 21 % |
Die Tabelle zeigt auch, dass Regeln, die der Mensch aus Spielspaß wollte (Spiel bis zum Ende, offenere Kämpfe), die Balance jedes Mal kräftig verschoben haben. Die Stufen wurden danach neu eingestellt, ohne den KIs Werte zu schenken: Sie unterscheiden sich nur darin, wie mutig sie angreifen, wie sie Joker einsetzen und wann sie sich verbünden.
Heutiger Stand. Nachmessung am 10.11.2026 auf Version 8.2.12, 300 Partien je Zelle, 3.600 Partien insgesamt:
| KIs | Sieg Mensch Narrow / General / Super | Runden (Median) | 90 % der Partien enden bis Runde | Kämpfe je Partie |
|---|---|---|---|---|
| 1 | 91 / 72 / 51 % | 9 / 11 / 11 | 19 | 53 |
| 2 | 85 / 54 / 29 % | 15 / 14 / 12 | 26 | 102 |
| 3 | 81 / 51 / 21 % | 17 / 18 / 13 | 31 | 155 |
| 4 | 78 / 57 / 17 % | 21 / 20 / 12 | 36 | 211 |
Was sich gegenüber dem Ausgang verändert hat:
- Die Stufen sind deutlich spürbar. Narrow ist leicht, General ist ein offenes Spiel, Super gewinnt meist und schneller.
- Keine Partie blieb nach 200 Runden offen.
- Die Führung wechselt zuletzt nach knapp der Hälfte der Partie (40 bis 49 %, vorher rund ein Drittel). Partien bleiben also länger offen.
- Rund 15 % der Züge enden ohne Angriff, Angriffe gelingen zu 82 bis 86 %, denn wer angreift, sucht sich meist ein schwächeres Feld.
3.7 Gefühl gegen Zahl: der lesbare Kampf
Vorgabe war: 8 gegen 5 verliert selten, 2 gegen 4 gewinnt praktisch nie. Mit dem Kampfglück (eingeführt, weil knappe Kämpfe offener sein sollten) gilt heute: 8 gegen 5 gewinnt zu 89 %, 2 gegen 4 zu 14 %. Gleichstand liegt bei 47 %, ein Punkt Vorsprung bei 65 bis 67 %. Zwei berechtigte Wünsche, lesbare Kämpfe und offene Kämpfe, ziehen in entgegengesetzte Richtungen. Die Zahl macht den Kompromiss sichtbar, entscheiden muss der Mensch.
3.8 Der Bau selbst
- 147 Commits vom 05. bis 08.11.2026 (7, 57, 53 und 30 je Tag), bis Version 8.2.12.
- Spiellogik, Gegner, 2D- und 3D-Welt schrieb der KI-Agent. 3D-Figuren, Musik und Klänge entstanden mit generativer KI.
- Jede Regeländerung lief über eine Entscheidung des Menschen. Manches wurde nach dem Ausprobieren wieder verworfen, etwa kombinierbare Joker oder Strommasten in 3D (zu hektisch).
4. Erkenntnisse
- Unsere Anfangshypothese war falsch. Bauchgefühl beim Testspielen hat die frühe Entscheidung der Partien, die wirkungslosen Mechaniken und den unsichtbaren Hebel des Anzugsrechts nicht bemerkt. Die Simulation hat das in Minuten gezeigt.
- Das Wichtige ist oft unsichtbar. Wer zuerst zieht und wann angegriffen werden darf, wog schwerer als jede Karte. Sichtbare Mechaniken, in die viel Liebe floss, wirkten teils gar nicht.
- Naheliegende Lösungen messen, bevor man sie baut. Der Einkommensdeckel klang vernünftig und hätte das Spiel zerstört.
- Fairness ohne Schummeln ist möglich. Die KI-Stufen sind heute klar gestuft, obwohl alle Fraktionen nach denselben Regeln mit denselben Werten spielen.
- Die Arbeitsteilung trägt. Der Mensch bringt Ziel und Geschmack, der Agent Tempo und Messung. Das Entscheiden bleibt beim Menschen, und genau dort braucht er die Zahlen.
5. Grenzen
- Bot statt Mensch. Die Seite der Menschen spielt in der Simulation ein Bot mit KI-Logik. Echte Menschen spielen anders, mutiger, fehlerhafter, mit Joker-Ideen, die der Bot nicht hat. Die Siegquoten sind Vergleichswerte zwischen Regelständen, keine Vorhersage für echte Spielerinnen und Spieler.
- Schwankung. Bei 120 bis 400 Partien je Einstellung liegen Unterschiede unter etwa 5 bis 9 Prozentpunkten im Rauschen.
- Spaß ist keine Messgröße. Spannung, Klang und Optik haben wir nicht gemessen, sondern entschieden.
- Ein Mensch, ein Agent. Die Erfahrung zur Arbeitsteilung stammt aus einem Projekt. Sie ist ein Erfahrungsbericht, kein Vergleich.
6. Offene Fragen
- Wie gut sagt der Bot echtes Spielverhalten voraus? Gewinnen Menschen gegen General AI wirklich etwa jede zweite Partie?
- Wie lässt sich ein Comeback ermöglichen, ohne die Partie endlos zu machen? Keine getestete Variante hat Comebacks spürbar verbessert.
- Unterscheiden sich die Fraktionen für Spielende so stark, wie es die Messung zeigt, oder nur auf dem Papier?
- Spielen Menschen in 2D anders als in 3D?
7. Nächste Experimente
- Spieltests mit Menschen. Kleine Runden in unseren Workshops: Siegquote, Partielänge und Abbrüche echter Spielerinnen und Spieler gegen die Bot-Werte legen.
- Comeback-Mechanik. Neue Ideen in der Simulation gegen die Messgröße „Sieg nach unter 15 % Fläche“ prüfen.
- Fraktionscharakter. Messen, ob die Spielweisen der vier KIs beim Spielen erkannt werden.
- Kampf-Lesbarkeit. Varianten des Kampfglücks gegen die Vorgabe „2 gegen 4 gewinnt praktisch nie“ messen und dem Menschen zur Wahl stellen.
Schluss
AI WARS ist ein Spiel, aber auch eine kleine Versuchsanordnung für die Frage, wie Menschen und KI-Agenten zusammen etwas bauen. Unsere wichtigste Lehre: Der Agent macht nicht nur schneller, er macht messbar. Entscheiden muss trotzdem der Mensch.
Jetzt spielen · Zur Projektseite · Was wir im KI-Labor lernen, geben wir in unseren Workshops weiter.